 Petr Skoda
Když firma nasadí jazykový model a zeptá se ho na něco z vlastní interní dokumentace, model si často něco vymyslí. Není to chyba modelu, jen důsledek toho, jak funguje. Model zná jen to, co viděl při trénování, a firemní směrnice, technickou dokumentaci nebo poslední verzi ceníku v tom typicky nemá. Řešením tohoto problému je přístup zvaný RAG, tedy retrieval augmented generation.
Co RAG vlastně dělá
RAG spojuje dvě věci, které samy o sobě fungují dobře, ale teprve dohromady dávají použitelný nástroj. První částí je vyhledávání, tedy schopnost najít v interních dokumentech firmy ty pasáže, které souvisí s konkrétním dotazem. Druhou částí je samotný jazykový model, který z nalezených pasáží sestaví srozumitelnou odpověď.
Místo toho, aby model odpovídal jen z toho, co se naučil při trénování, dostane před vygenerováním odpovědi k dispozici konkrétní úryvky z firemních dokumentů, a odpověď staví na nich. Výsledkem je odpověď, která se dá dohledat ve zdrojovém dokumentu, ne odpověď, kterou si model odvodil ze statistických vzorů bez jakékoliv opory.
Jak to funguje v praxi
Firemní dokumenty, směrnice nebo technická dokumentace se nejprve rozdělí na menší části a převedou na takzvané embeddingy, tedy číselnou reprezentaci významu textu. Tyto embeddingy se uloží do vektorové databáze, což je databáze optimalizovaná na hledání podle významu, ne podle přesné shody slov.
Když pak zaměstnanec položí dotaz, systém nejprve najde ve vektorové databázi ty části dokumentace, které jsou dotazu významově nejblíž, a teprve potom je spolu s dotazem pošle jazykovému modelu. Model dostane přesný kontext, ze kterého má vycházet, a jeho úkolem už není si fakta vymýšlet, ale správně je poskládat do odpovědi.
Proč to firmy potřebují místo obyčejného chatbota
Obecný jazykový model bez přístupu k firemním datům umí odpovídat na obecné otázky, ale nezná aktuální ceník, interní postupy ani historii konkrétního zákazníka. RAG tento nedostatek řeší tak, že model propojí přímo s aktuálním obsahem firemní znalostní báze, aniž by bylo nutné model přetrénovávat pokaždé, když se něco v dokumentaci změní.
Další výhodou je kontrola nad daty. Vektorová databáze zůstává v infrastruktuře firmy nebo jejího dodavatele, takže citlivá interní dokumentace nemusí být součástí trénovacích dat žádného modelu a firma si zachovává přehled o tom, co přesně systém při odpovídání používá.
Kde v tom pomáhá Eniware
Budování RAG systémů nad interní dokumentací je jednou z hlavních věcí, které Eniware pro firmy staví. Cílem je AI, která odpovídá na základě reálného obsahu firmy, ne na základě obecných znalostí z internetu, a která se dá nasadit nad existující dokumentaci, wiki nebo firemní znalostní bázi bez nutnosti cokoliv přepisovat od nuly.
Pokud vaše firma zvažuje nasazení AI nad vlastní dokumentací, dává smysl začít menší pilotní oblastí, třeba jedním konkrétním typem dotazů, a na ní si celý přístup ověřit.
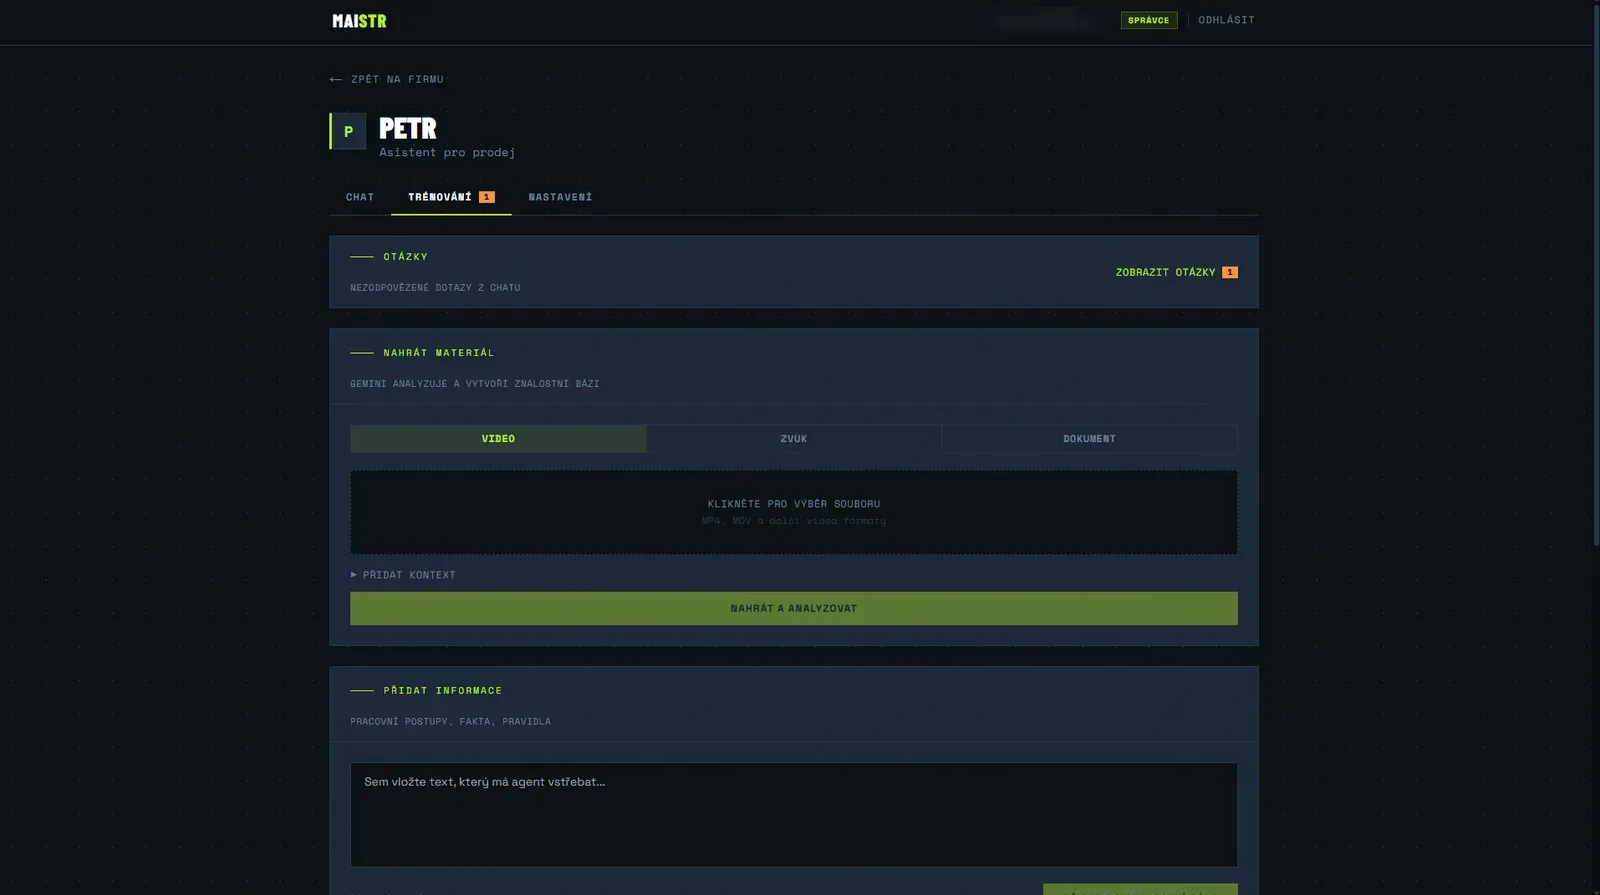
Pokud vás zajímá, jak takový systém vypadá v praxi, ukazujeme to na konkrétním příkladu v case study o aplikaci MAistr. Pokud byste chtěli jít ještě dál a provozovat i samotný jazykový model ve vlastní infrastruktuře, tomu se věnujeme v článku o vlastním AI modelu na vašem zařízení.